Ekstern validering
Per Erik Haugedal og Karl Ove Hufthammer
Source:vignettes/ekstern-validering.Rmd
ekstern-validering.RmdInnleiing
I rapwhale finst ein infrastruktur – eit sett
R-funksjonar og tilhøyrande metodikk – for ekstern validering
av registerdata. Målet med denne har vore å gjera det enklare, raskare
og sikrare å gjennomføra ekstern validering av høg kvalitet.
Ekstern validering går her ut på å finna ut om dataa i registeret er lik dataa i ein gitt gullstandard, typisk ein pasientjournal. For meir informasjon, sjå Nasjonalt servicemiljø for medisinske kvalitetsregistre si informasjonsside om korrektheit og Veileder i datakvalitet.
Me har laga eit standardisert format for valideringsdata og eit sett R-funksjonar for å analysera og laga datasett på dette formatet. La oss først sjå nærare på formatet me har komme fram til.
Format til valideringsdatasett
I eit valideringsdatsett må me for kvar måling (for eksempel vekta eller høgda til ein person) registrera verdien av målinga i registeret (intern verdi) og tilhøyrande verdi i den eksterne kjelda (ekstern verdi), gullstandarden. I tillegg treng me informasjon om kva pasient eller forløp verdien gjeld samt kva for variabel det er snakk om.
Første forsøk på eit format
I utgangspunktet verkar eit format som dette fornuftig:
| pasid | varnamn | verdi_intern | verdi_ekstern |
|---|---|---|---|
| 5 | vekt | 78 | 78 |
| 7 | vekt | 53 | 53 |
| 7 | hogd | 196 | 186 |
Her kan me registrera høgda og vekta til kvar pasient (identifisert
med pasient-ID, pasid), både internt i registeret og i den
eksterne kjelda.
Men for meir realistiske datasett støyter me fort på problem, som me har løyst med eit utvida og endeleg format.
Utvida og endeleg format
Det er tre potensielle problem – at ein pasient kan ha fleire målingar av same variabel, at me kan ha målingar av ulike datatypar (eksempelvis både tal og datoar) og at indeksvariablar kan ha same namn som verdivariablane.
Ein pasient kan ha fleire målingar av same variabel dersom
han vore til fleire undersøkingar. Det løyser me enkelt ved å tillata
fleire indeksvariablar, for eksempel både pasient-ID og
undersøkingsdato. Dette er variablar som saman med
vld_varnamn unikt identifiserer kvar måling. (Det svarar
altså til primærnøklar i databasar.)
Eit register har vanlegvis målingar av ulike datatypar, for
eksempel både tal (som ovanfor) og datoar eller logiske variablar
(TRUE/FALSE). Men i dei fleste datasystem kan
ein kolonne berre innehalda data av éin type. Dette løyser me ved å
innføra fleire verdikolonnar, éin for kvar datatype. Me treng då òg ein
kolonne (vld_vartype) som seier kva type variabel som kvar
verdi gjeld.
I sjeldne tilfelle har indeksvariablar same namn som verdivariablane. Det prøver me å løysa ved at alle variablar utanom indeksvariablane får prefikset vld_ («validering»). Dette vert då å rekna som eit reservert prefiks.
I det endelege formatet er det framleis slik at kvar rad indentifiserer ei måling (med to verdiar, éin intern og éin ekstern):
| pasid | dato_inn | vld_varnamn | vld_vartype | vld_verdi_intern_dato | vld_verdi_ekstern_dato | vld_verdi_intern_tal | vld_verdi_ekstern_tal |
|---|---|---|---|---|---|---|---|
| 5 | 2020-06-07 | vekt | tal | NA | NA | 78 | 78 |
| 5 | 2020-06-07 | dato_ut | dato | 2020-06-15 | 2020-06-15 | NA | NA |
| 5 | 2020-12-13 | vekt | tal | NA | NA | NA | NA |
| 5 | 2020-12-13 | dato_ut | dato | 2020-12-13 | 2020-12-14 | NA | NA |
| 7 | 2020-08-07 | vekt | tal | NA | NA | 53 | 53 |
| 7 | 2020-08-09 | hogd | tal | NA | NA | 196 | 194 |
| 7 | 2020-08-09 | dato_ut | dato | 2020-08-13 | 2020-08-13 | NA | NA |
Her utgjer pasid (pasient-ID) og dato_inn
(innskrivingsdato) indeksvariablane som saman unikt
identifiserer ei måling (rad). Pasient 5 har hatt to opphald og pasient
7 eitt. (På det andre opphaldet til pasient 5 hadde ein gløymt å vega
pasienten.) Me vil samanlikna kva verdiar dei tre variablane
vekt (vekta til pasienten), hogd (høgda til
pasienten) og dato_ut (utskrivingsdatoen for pasienten) har
i registeret med tilhøyrande verdiar i den eksterne kjelda.
Bruk av valideringsdatasett
Når me har eit ferdig utfylt valideringsdatsett, er det svært lett å samananlikna dei interne og eksterne verdiane. Så kan me rekna ut statistikk som seier kor korrekte dataa er, og til slutt kan me bruka statistikken i tabellar og figurar i valideringsrapportar.
Valideringsdatasetta har me i R implementert som vanlege datarammer/tibble-objekt:
d_vld
#> # A tibble: 7 × 8
#>   pasid dato_inn   vld_varnamn vld_vartype vld_verdi_intern_dato
#>   <dbl> <date>     <chr>       <chr>       <date>
#> 1     5 2020-06-07 vekt        tal         NA
#> 2     5 2020-06-07 dato_ut     dato        2020-06-15
#> 3     5 2020-12-13 vekt        tal         NA
#> 4     5 2020-12-13 dato_ut     dato        2020-12-13
#> 5     7 2020-08-07 vekt        tal         NA
#> 6     7 2020-08-09 hogd        tal         NA
#> 7     7 2020-08-09 dato_ut     dato        2020-08-13
#> # ℹ 3 more variables: vld_verdi_ekstern_dato <date>,
#> #   vld_verdi_intern_tal <dbl>, vld_verdi_ekstern_tal <dbl>
Samanlikning av interne og eksterne verdiar
Til å samanlikna verdiane brukar me
analyser_valideringsdatasett():
d_samanlikna = d_vld |>
analyser_valideringsdatasett()| pasid | dato_inn | vld_varnamn | vld_vartype | vld_verdi_intern_dato | vld_verdi_ekstern_dato | vld_verdi_intern_tal | vld_verdi_ekstern_tal | ki_krit_teller | ki_krit_nevner |
|---|---|---|---|---|---|---|---|---|---|
| 5 | 2020-06-07 | vekt | tal | NA | NA | 78 | 78 | TRUE | TRUE |
| 5 | 2020-06-07 | dato_ut | dato | 2020-06-15 | 2020-06-15 | NA | NA | TRUE | TRUE |
| 5 | 2020-12-13 | vekt | tal | NA | NA | NA | NA | TRUE | TRUE |
| 5 | 2020-12-13 | dato_ut | dato | 2020-12-13 | 2020-12-14 | NA | NA | FALSE | TRUE |
| 7 | 2020-08-07 | vekt | tal | NA | NA | 53 | 53 | TRUE | TRUE |
| 7 | 2020-08-09 | hogd | tal | NA | NA | 196 | 194 | FALSE | TRUE |
| 7 | 2020-08-09 | dato_ut | dato | 2020-08-13 | 2020-08-13 | NA | NA | TRUE | TRUE |
Den nye kolonnen ki_krit_teller seier om dei interne og
dei eksterne verdiane er like. Merk at to
NA-verdiar som standard vert rekna som like (noko som ikkje
er vanleg i R). Tanken bak dette er at om for eksempel vekt
ikkje er registrert i registeret, så skal heller ikkje
vektinformasjon finnast i pasientjournalen, og vice versa.
Men dersom gullstandarden og registeret ikkje har same
kjelde til data, for eksempel viss me samanliknar pasient- og
legerapporterte data, kan me ynskja eit visst slingringsmonn ved
samanlikningane. Me kan for eksempel ynskja at måling av vekt skal ha
eit slingringsmonn på 4 (kg), måling av høgd skal ha eit slingringsmonn
på 2 (cm), men operasjonsdatoen må vera heilt nøyaktig. Dette kan ein få
til ved å laga eigne samanliknarfunksjonar (argumentet
samanliknar). Sjå hjelpesida til
analyser_valideringsdatasett() for krava til slike
funksjonar, og samanlikn_identisk() for eit eksempel.
Utrekning av korrektheitsstatistikk
Som vist ovanfor, legg analyser_valideringsdatasett()
til to kolonnar, ki_krit_teller, som me alt har
sett på, og ki_krit_nevner, som er TRUE for
alle radene. I praksis lagar me ein altså eit formelt
kvalitetsindikator-datasett (sjå vignetten Kvalitetsindikatorfunksjonar), noko som
gjer at me kan bruka aggreger_ki_prop() for å rekna ut
korrektheitstatistikk, både totalt og stratifisert på éin eller fleire
variablar.
Total korrektheit
Total korrektheit reknar me ut direkte med
aggreger_ki_prop():
d_samanlikna |>
  aggreger_ki_prop()
#> # A tibble: 1 × 5
#>     est ki_teller ki_nevner konfint_nedre konfint_ovre
#>   <dbl>     <int>     <int>         <dbl>        <dbl>
#> 1 0.714         5         7         0.359        0.918
Her ser me at 5 av 7 (dvs. 71 %) av verdiane var like i registeret og gullstandarden. Me får òg ut tilhøyrande 95 %-konfidensintervall.
Korrektheit per variabel
Nokre variablar er gjerne oftare korrekt registrerte enn andre. Me
kan lett få ut stratifisert statistikk ved å bruka
group_by():
d_samanlikna |>
  group_by(vld_varnamn) |>
  aggreger_ki_prop()
#> # A tibble: 3 × 6
#>   vld_varnamn   est ki_teller ki_nevner konfint_nedre konfint_ovre
#>   <chr>       <dbl>     <int>     <int>         <dbl>        <dbl>
#> 1 dato_ut     0.667         2         3         0.208        0.939
#> 2 hogd        0             0         1         0            0.793
#> 3 vekt        1             3         3         0.439        1
Tilsvarande kan me rekna ut korrektheit per sjukehus, per variabel per sjukehus, eller over tid (ved å ha år og månad som grupperingsvariablar).
Bruk av statistikken
Til slutt kan me visa statistikken i fine tabellar og figurar. Her er eit komplett eksempel på bruk av eit valideringsdatasett, med figur:
# Rekn ut korrektheit per variabel
d_korrektheit = d_vld |>
  analyser_valideringsdatasett() |>
  group_by(vld_varnamn) |>
  aggreger_ki_prop()

# Eventuelt sorter for å få finare grafar og tabellar
d_korrektheit_sortert = d_korrektheit |>
  arrange(est) |>
  mutate(varnamn_sortert = forcats::fct_inorder(vld_varnamn))
# Brukte her arrange() for at resultatet lett skal kunna brukast
# i tabellar òg. Skal me berre laga grafar, kunne me heller bruka
# forcats::fct_reorder() direkte i mutate()-steget.
# I mutate()-steget kan me godt òg laga finare variabelnamn ...

# Enkel figur
library(ggplot2)
ggplot(
  d_korrektheit_sortert,
  aes(
    x = est, xmin = konfint_nedre, xmax = konfint_ovre,
    y = varnamn_sortert
  )
) +
  geom_pointrange() +
  scale_x_continuous(labels = scales::percent) +
  ggtitle("Korrektheit for utvalde variablar") +
  xlab("Korrekt") +
  ylab(NULL)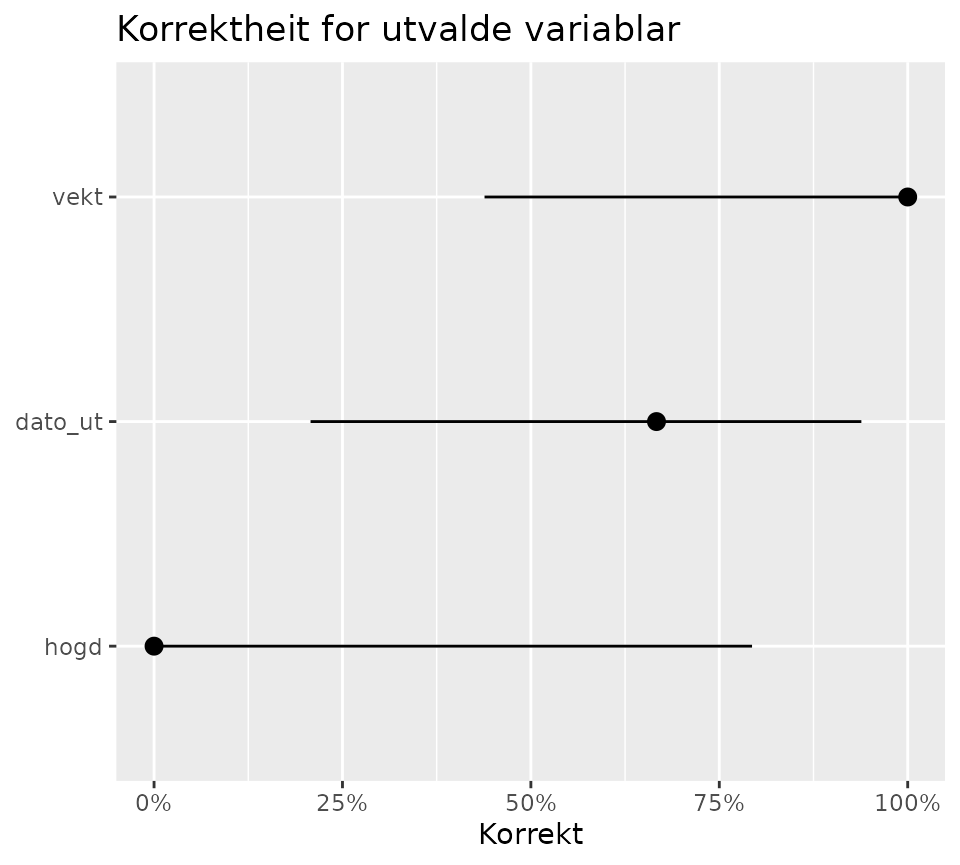
# nolint endHer kan (og bør) me sjølvsagt finpussa figuren for å gjera han meir brukarvennleg, men det er ikkje tema for denne vignetten.
Me tilrår elles òg sterkt å bruka SPC-metodikk, ikkje konfidensintervall, for samanlikning av korrektheit, for eksempel mellom ulike sjukehus eller over tid, men det er heller ikkje tema her.
Generering av valideringsdatasett
Denne pakken har funksjonar for enkelt å laga klar
valideringsdatasett. Først treng me registerdata, lagra som eitt eller
fleire datasett. Så kan me bruka lag_valideringsdatasett()
til å laga valideringsdatasett, og til slutt kan me tilpassa dette
datasettet slik at me berre treng validera dei variablane og verdiane me
er intersserte i.
Eksempel på register
Me har eit enkelt register som registrerer vekt, høgd, om pasienten har opplevd biverknadar, kva type biverknadar og om pasienten er gravid. Nokre av variablane i registeret kan sjå slik ut:
| pasid | dato_inn | sjukehus | dato_ut | vekt | hogd | biverk | biverk_hovud | biverk_mage | biverk_fot | gravid |
|---|---|---|---|---|---|---|---|---|---|---|
| 5 | 2020-06-07 | Bergen | 2020-06-15 | 78 | 183 | TRUE | FALSE | TRUE | TRUE | NA |
| 5 | 2020-12-13 | Førde | 2020-12-13 | 50 | 179 | TRUE | FALSE | TRUE | TRUE | NA |
| 7 | 2020-08-09 | Bergen | 2020-08-13 | 711 | 196 | TRUE | TRUE | TRUE | TRUE | TRUE |
| 13 | 2021-01-05 | Førde | NA | NA | 163 | FALSE | NA | NA | NA | NA |
| 14 | 2021-01-05 | Førde | 2021-01-09 | 101 | 182 | TRUE | TRUE | FALSE | FALSE | NA |
I dette eksempelet er indeksvariablane pasid og
dato_inn. Sjukehus er alltid registrert rett, så det er ein
variabel me ikkje er interessert i å validera. Me fjernar han derfor før
me genererer valideringsdatasettet.
d_reg = select(d_reg_full, -sjukehus)Komplett valideringsdatasett
Når me køyrer lag_valideringsdatasett(), får me ut eit
komplett valideringsdatasett, der alle pasientar/forløp og alle
datavariablar er med. Talet på rader vert då lik talet på rader i det
opphavlege datasettet gongar talet på datavariablar. Her har me 5
pasientforløp og 8 datavariablar, og me får såleis eit
valideringsdatasett med 40 rader:
d_vld = lag_valideringsdatasett(d_reg, indvars = c("pasid", "dato_inn"))| pasid | dato_inn | vld_varnamn | vld_vartype | vld_verdi_intern_Date | vld_verdi_ekstern_Date | vld_verdi_intern_numeric | vld_verdi_ekstern_numeric | vld_verdi_intern_logical | vld_verdi_ekstern_logical |
|---|---|---|---|---|---|---|---|---|---|
| 5 | 2020-06-07 | dato_ut | Date | 2020-06-15 | NA | NA | NA | NA | NA |
| 5 | 2020-06-07 | vekt | numeric | NA | NA | 78 | NA | NA | NA |
| 5 | 2020-06-07 | hogd | numeric | NA | NA | 183 | NA | NA | NA |
| 5 | 2020-06-07 | biverk | logical | NA | NA | NA | NA | TRUE | NA |
| 5 | 2020-06-07 | biverk_hovud | logical | NA | NA | NA | NA | FALSE | NA |
| 5 | 2020-06-07 | biverk_mage | logical | NA | NA | NA | NA | TRUE | NA |
| 5 | 2020-06-07 | biverk_fot | logical | NA | NA | NA | NA | TRUE | NA |
| 5 | 2020-06-07 | gravid | logical | NA | NA | NA | NA | NA | NA |
| 5 | 2020-12-13 | dato_ut | Date | 2020-12-13 | NA | NA | NA | NA | NA |
| 5 | 2020-12-13 | vekt | numeric | NA | NA | 50 | NA | NA | NA |
| 5 | 2020-12-13 | hogd | numeric | NA | NA | 179 | NA | NA | NA |
| 5 | 2020-12-13 | biverk | logical | NA | NA | NA | NA | TRUE | NA |
| 5 | 2020-12-13 | biverk_hovud | logical | NA | NA | NA | NA | FALSE | NA |
| 5 | 2020-12-13 | biverk_mage | logical | NA | NA | NA | NA | TRUE | NA |
| 5 | 2020-12-13 | biverk_fot | logical | NA | NA | NA | NA | TRUE | NA |
| 5 | 2020-12-13 | gravid | logical | NA | NA | NA | NA | NA | NA |
| 7 | 2020-08-09 | dato_ut | Date | 2020-08-13 | NA | NA | NA | NA | NA |
| 7 | 2020-08-09 | vekt | numeric | NA | NA | 711 | NA | NA | NA |
| 7 | 2020-08-09 | hogd | numeric | NA | NA | 196 | NA | NA | NA |
| 7 | 2020-08-09 | biverk | logical | NA | NA | NA | NA | TRUE | NA |
| 7 | 2020-08-09 | biverk_hovud | logical | NA | NA | NA | NA | TRUE | NA |
| 7 | 2020-08-09 | biverk_mage | logical | NA | NA | NA | NA | TRUE | NA |
| 7 | 2020-08-09 | biverk_fot | logical | NA | NA | NA | NA | TRUE | NA |
| 7 | 2020-08-09 | gravid | logical | NA | NA | NA | NA | TRUE | NA |
| 13 | 2021-01-05 | dato_ut | Date | NA | NA | NA | NA | NA | NA |
| 13 | 2021-01-05 | vekt | numeric | NA | NA | NA | NA | NA | NA |
| 13 | 2021-01-05 | hogd | numeric | NA | NA | 163 | NA | NA | NA |
| 13 | 2021-01-05 | biverk | logical | NA | NA | NA | NA | FALSE | NA |
| 13 | 2021-01-05 | biverk_hovud | logical | NA | NA | NA | NA | NA | NA |
| 13 | 2021-01-05 | biverk_mage | logical | NA | NA | NA | NA | NA | NA |
| 13 | 2021-01-05 | biverk_fot | logical | NA | NA | NA | NA | NA | NA |
| 13 | 2021-01-05 | gravid | logical | NA | NA | NA | NA | NA | NA |
| 14 | 2021-01-05 | dato_ut | Date | 2021-01-09 | NA | NA | NA | NA | NA |
| 14 | 2021-01-05 | vekt | numeric | NA | NA | 101 | NA | NA | NA |
| 14 | 2021-01-05 | hogd | numeric | NA | NA | 182 | NA | NA | NA |
| 14 | 2021-01-05 | biverk | logical | NA | NA | NA | NA | TRUE | NA |
| 14 | 2021-01-05 | biverk_hovud | logical | NA | NA | NA | NA | TRUE | NA |
| 14 | 2021-01-05 | biverk_mage | logical | NA | NA | NA | NA | FALSE | NA |
| 14 | 2021-01-05 | biverk_fot | logical | NA | NA | NA | NA | FALSE | NA |
| 14 | 2021-01-05 | gravid | logical | NA | NA | NA | NA | NA | NA |
For å ikkje få for breie tabellar viser me berre nokre av kolonnane i dei vidare eksempla:
d_vld_enkel = select(d_vld, pasid:vld_vartype)Tilfeldig rekkjefølgje og utval
Om me vil, kan me no validera heile datasettet (ved å samanlikna det med gullstandraden). Men i praksis vil me ta ein stikkprøve.
Kanskje har me berre tid til å validera ti målingar:
set.seed(12345) # For reproduserbare «tilfeldige» trekkingar
slice_sample(d_vld_enkel, n = 10)
#> # A tibble: 10 × 4
#>    pasid dato_inn   vld_varnamn  vld_vartype
#>    <dbl> <date>     <chr>        <chr>
#>  1     5 2020-12-13 biverk_mage  logical
#>  2     5 2020-12-13 gravid       logical
#>  3    13 2021-01-05 vekt         numeric
#>  4    13 2021-01-05 biverk       logical
#>  5     7 2020-08-09 gravid       logical
#>  6    13 2021-01-05 biverk_hovud logical
#>  7     5 2020-12-13 hogd         numeric
#>  8    13 2021-01-05 gravid       logical
#>  9    14 2021-01-05 biverk       logical
#> 10     5 2020-06-07 vekt         numeric
Eller ti prosent av datasettet:
slice_sample(d_vld_enkel, prop = 0.1)
#> # A tibble: 4 × 4
#>   pasid dato_inn   vld_varnamn vld_vartype
#>   <dbl> <date>     <chr>       <chr>
#> 1     7 2020-08-09 biverk_mage logical
#> 2     5 2020-12-13 hogd        numeric
#> 3    14 2021-01-05 biverk_mage logical
#> 4    13 2021-01-05 biverk_mage logical
I nokre tilfelle kan me ikkje garantera tid til å validera eit visst tal eller ein viss prosentdel av målingane. Ei pragmatisk løysing er då gjera klar heile valideringsdatasettet, men i tilfeldig rekkjefølgje. Når me skal gjennomføra valideringa, startar me på toppen og arbeider oss nedover. Når me slepp opp for tid, slettar me rett og slett dei resterande radene. Me har likevel eit tilfeldig utval rader:
slice_sample(d_vld_enkel, prop = 1)
#> # A tibble: 40 × 4
#>    pasid dato_inn   vld_varnamn vld_vartype
#>    <dbl> <date>     <chr>       <chr>
#>  1     5 2020-12-13 vekt        numeric
#>  2     7 2020-08-09 dato_ut     Date
#>  3    13 2021-01-05 gravid      logical
#>  4    13 2021-01-05 biverk_mage logical
#>  5     5 2020-06-07 dato_ut     Date
#>  6     5 2020-12-13 biverk      logical
#>  7     7 2020-08-09 biverk      logical
#>  8     5 2020-06-07 gravid      logical
#>  9    13 2021-01-05 vekt        numeric
#> 10    14 2021-01-05 hogd        numeric
#> # ℹ 30 more rows
Valideringsdatasett med forløp i tilfeldig rekkjefølgje
Når me jamfører registerdata med for eksempel pasientjournalar, er praktisk å sjå på alle datavariablane samla for kvar pasient, slik at me ikkje heile tida må veksla mellom journalar. Me har for eksempel fått denne stikkprøven med valideringsdata:
d_vld_utval = d_vld_enkel[c(18, 32, 1, 40, 2, 17), ]
d_vld_utval
#> # A tibble: 6 × 4
#>   pasid dato_inn   vld_varnamn vld_vartype
#>   <dbl> <date>     <chr>       <chr>
#> 1     7 2020-08-09 vekt        numeric
#> 2    13 2021-01-05 gravid      logical
#> 3     5 2020-06-07 dato_ut     Date
#> 4    14 2021-01-05 gravid      logical
#> 5     5 2020-06-07 vekt        numeric
#> 6     7 2020-08-09 dato_ut     Date
Her er ein enkel måte å samla dataa på, men som samtidig sikrar tilfeldig rekkjefølgje på pasientane (som er viktig for validiteten)
set.seed(1) # For reproduserbare «tilfeldige» trekkingar
d_vld_utval_samla = d_vld_utval |>
  group_by(pasid, dato_inn) |> # Ev. bruk nest_by()
  nest() |>
  ungroup() |> # Nødvendig for slice_sample()
  slice_sample(prop = 1) |>
  unnest(data)
d_vld_utval_samla
#> # A tibble: 6 × 4
#>   pasid dato_inn   vld_varnamn vld_vartype
#>   <dbl> <date>     <chr>       <chr>
#> 1     7 2020-08-09 vekt        numeric
#> 2     7 2020-08-09 dato_ut     Date
#> 3     5 2020-06-07 dato_ut     Date
#> 4     5 2020-06-07 vekt        numeric
#> 5    14 2021-01-05 gravid      logical
#> 6    13 2021-01-05 gravid      logical
Viss me heller berre vil ha eit utval av forløpa, endrar me
berre n-verdien i slice_sample().
Variablar i fast rekkjefølgje
Det er gjerne praktisk at datavariablane kjem i same rekkjefølgje for alle pasientane, Det kan for eksempel vera rekkjefølgja opplysningane står i i pasientjournalen. Det ordnar me lett.
I dette eksempelet brukar me variabelrekkjefølgja frå det opphavlege datasettet:
var_rekkjefolgje = names(d_reg_full)
d_vld_utval |>
  arrange(match(vld_varnamn, !!var_rekkjefolgje))
#> # A tibble: 6 × 4
#>   pasid dato_inn   vld_varnamn vld_vartype
#>   <dbl> <date>     <chr>       <chr>
#> 1     5 2020-06-07 dato_ut     Date
#> 2     7 2020-08-09 dato_ut     Date
#> 3     7 2020-08-09 vekt        numeric
#> 4     5 2020-06-07 vekt        numeric
#> 5    13 2021-01-05 gravid      logical
#> 6    14 2021-01-05 gravid      logical
(Og så kan me bruka oppskrifta frå førre avsnitt for å få dataa frå same pasient samla.)
Tilfeldig utval av fast tal pasientar og variablar
Alt ovanfor kan sjølvsagt kombinerast. Viss me vil trekkja 5 forløp og 2 variablar per forløp, kan me gjera det slik:
set.seed(1) # For reproduserbare «tilfeldige» trekkingar
n_forlop = 5 # Talet på forløp
n_var = 2 # Talet på variablar per forløp
d_vld_utval = d_vld_enkel |>
  group_by(pasid, dato_inn) |>
  slice_sample(n = n_var) |>
  nest() |>
  ungroup() |> # Nødvendig for slice_sample()
  slice_sample(n = n_forlop) |>
  unnest(data)
print(d_vld_utval, n = Inf) # 10 rader
#> # A tibble: 10 × 4
#>    pasid dato_inn   vld_varnamn  vld_vartype
#>    <dbl> <date>     <chr>        <chr>
#>  1     7 2020-08-09 vekt         numeric
#>  2     7 2020-08-09 biverk_hovud logical
#>  3    14 2021-01-05 biverk_mage  logical
#>  4    14 2021-01-05 vekt         numeric
#>  5     5 2020-06-07 dato_ut      Date
#>  6     5 2020-06-07 biverk       logical
#>  7    13 2021-01-05 biverk_fot   logical
#>  8    13 2021-01-05 hogd         numeric
#>  9     5 2020-12-13 biverk_fot   logical
#> 10     5 2020-12-13 dato_ut      Date
Utval av variablar i ferdige valideringsdatasett
Dersom ein berre skal sjå på eit utval av variablane, kan me anten
gjer dette før me lagar valideringsdatasettet (slik me gjorde
med sjukehus-variabelen) eller ved filtrering etterpå. Viss
me for eksempel ikkje vil ha med biverknadsvariablane i eit allereie
laga valideringsdatasett, kan me fjerna dei slik:
d_vld |>
  filter(str_starts(vld_varnamn, "biverk", negate = TRUE))
#> # A tibble: 20 × 10
#>    pasid dato_inn   vld_varnamn vld_vartype vld_verdi_intern_Date
#>    <dbl> <date>     <chr>       <chr>       <date>
#>  1     5 2020-06-07 dato_ut     Date        2020-06-15
#>  2     5 2020-06-07 vekt        numeric     NA
#>  3     5 2020-06-07 hogd        numeric     NA
#>  4     5 2020-06-07 gravid      logical     NA
#>  5     5 2020-12-13 dato_ut     Date        2020-12-13
#>  6     5 2020-12-13 vekt        numeric     NA
#>  7     5 2020-12-13 hogd        numeric     NA
#>  8     5 2020-12-13 gravid      logical     NA
#>  9     7 2020-08-09 dato_ut     Date        2020-08-13
#> 10     7 2020-08-09 vekt        numeric     NA
#> 11     7 2020-08-09 hogd        numeric     NA
#> 12     7 2020-08-09 gravid      logical     NA
#> 13    13 2021-01-05 dato_ut     Date        NA
#> 14    13 2021-01-05 vekt        numeric     NA
#> 15    13 2021-01-05 hogd        numeric     NA
#> 16    13 2021-01-05 gravid      logical     NA
#> 17    14 2021-01-05 dato_ut     Date        2021-01-09
#> 18    14 2021-01-05 vekt        numeric     NA
#> 19    14 2021-01-05 hogd        numeric     NA
#> 20    14 2021-01-05 gravid      logical     NA
#> # ℹ 5 more variables: vld_verdi_ekstern_Date <date>,
#> #   vld_verdi_intern_numeric <dbl>, vld_verdi_ekstern_numeric <dbl>,
#> #   vld_verdi_intern_logical <lgl>, vld_verdi_ekstern_logical <lgl>
# nolint end
Bruk av logikk til å fjerna unødvendige rader
Nokre variablar gjev berre meining å sjekka dersom andre variablar
har visse verdiar. Variabelen gravid treng ein for eksempel
berre sjekka dersom pasienten er kvinne.
Merk at informasjon om kjønn ikkje finst i valideringsdatasettet, så me hentar det frå eit anna datasett. (Ein slik operasjon kan vera nyttig i mange samanhengar, for eksempel for å hekta fødselsnummer på valideringsdatasett, slik at det vert lettare å finna pasienten i pasientjournalen.)
# Koplar tabellen med kjønn på valideringsdatasettet
d_vld_med_kjonn = d_vld |>
  left_join(d_pas, by = "pasid", relationship = "many-to-one")

# Filtrerer vekk rader som gjeld graviditet for «ikkje-kvinner» (inkl. NA-kjønn)
d_vld_med_kjonn |>
  filter(!(vld_varnamn == "gravid" & kjonn != "kvinne"))
#> # A tibble: 36 × 11
#>    pasid dato_inn   vld_varnamn  vld_vartype vld_verdi_intern_Date
#>    <dbl> <date>     <chr>        <chr>       <date>
#>  1     5 2020-06-07 dato_ut      Date        2020-06-15
#>  2     5 2020-06-07 vekt         numeric     NA
#>  3     5 2020-06-07 hogd         numeric     NA
#>  4     5 2020-06-07 biverk       logical     NA
#>  5     5 2020-06-07 biverk_hovud logical     NA
#>  6     5 2020-06-07 biverk_mage  logical     NA
#>  7     5 2020-06-07 biverk_fot   logical     NA
#>  8     5 2020-12-13 dato_ut      Date        2020-12-13
#>  9     5 2020-12-13 vekt         numeric     NA
#> 10     5 2020-12-13 hogd         numeric     NA
#> # ℹ 26 more rows
#> # ℹ 6 more variables: vld_verdi_ekstern_Date <date>,
#> #   vld_verdi_intern_numeric <dbl>, vld_verdi_ekstern_numeric <dbl>,
#> #   vld_verdi_intern_logical <lgl>, vld_verdi_ekstern_logical <lgl>,
#> #   kjonn <chr>
Logikken kan sjølvsagt skrivast på mange (ekvivalente) måtar, for eksempel:
d_vld_med_kjonn |>
  filter(vld_varnamn != "gravid" | kjonn == "kvinne")
#> # A tibble: 36 × 11
#>    pasid dato_inn   vld_varnamn  vld_vartype vld_verdi_intern_Date
#>    <dbl> <date>     <chr>        <chr>       <date>
#>  1     5 2020-06-07 dato_ut      Date        2020-06-15
#>  2     5 2020-06-07 vekt         numeric     NA
#>  3     5 2020-06-07 hogd         numeric     NA
#>  4     5 2020-06-07 biverk       logical     NA
#>  5     5 2020-06-07 biverk_hovud logical     NA
#>  6     5 2020-06-07 biverk_mage  logical     NA
#>  7     5 2020-06-07 biverk_fot   logical     NA
#>  8     5 2020-12-13 dato_ut      Date        2020-12-13
#>  9     5 2020-12-13 vekt         numeric     NA
#> 10     5 2020-12-13 hogd         numeric     NA
#> # ℹ 26 more rows
#> # ℹ 6 more variables: vld_verdi_ekstern_Date <date>,
#> #   vld_verdi_intern_numeric <dbl>, vld_verdi_ekstern_numeric <dbl>,
#> #   vld_verdi_intern_logical <lgl>, vld_verdi_ekstern_logical <lgl>,
#> #   kjonn <chr>
Men ein kan lett gå seg bort i alle !-teikna og
parentesane som trengst for å uttrykka seg. Me tilrår derfor å bruka
impl()-funksjonen i rapwhale, som er ein enkel
måte å uttrykka sanningsverdiane i utsegn på forma «A impliserer B»
(altså «viss A, så B»). I vårt eksempel er logikken «viss me ser på
gravidvariabelen, så må det vera for ei kvinne»:
d_vld_med_kjonn |>
  filter(impl(vld_varnamn == "gravid", kjonn == "kvinne"))
#> # A tibble: 36 × 11
#>    pasid dato_inn   vld_varnamn  vld_vartype vld_verdi_intern_Date
#>    <dbl> <date>     <chr>        <chr>       <date>
#>  1     5 2020-06-07 dato_ut      Date        2020-06-15
#>  2     5 2020-06-07 vekt         numeric     NA
#>  3     5 2020-06-07 hogd         numeric     NA
#>  4     5 2020-06-07 biverk       logical     NA
#>  5     5 2020-06-07 biverk_hovud logical     NA
#>  6     5 2020-06-07 biverk_mage  logical     NA
#>  7     5 2020-06-07 biverk_fot   logical     NA
#>  8     5 2020-12-13 dato_ut      Date        2020-12-13
#>  9     5 2020-12-13 vekt         numeric     NA
#> 10     5 2020-12-13 hogd         numeric     NA
#> # ℹ 26 more rows
#> # ℹ 6 more variables: vld_verdi_ekstern_Date <date>,
#> #   vld_verdi_intern_numeric <dbl>, vld_verdi_ekstern_numeric <dbl>,
#> #   vld_verdi_intern_logical <lgl>, vld_verdi_ekstern_logical <lgl>,
#> #   kjonn <chr>
Logikk basert på fleire variablar
I nokre tilfelle kan samanhengen mellom variablane vera meir
kompleks. For eksempel fyller ein ut biverknads-«undervariablane»
biverk_hovud, biverk_mage og
biverk_fot viss og berre viss hovudvariabelen
biverk er TRUE. Det har ikkje noko for seg å
sjekka biverk_hovud viss biverk er
FALSE (gitt at innregistreringssystemet garanterer at ein
ikkje kan registrera inkonsistente verdiar, og gitt at
biverk alltid er til å stola på).
Her lagar me først eit uttrekk på vanleg vis, og så fjernar me dei radene som ikkje skal vera med:
# Først eit utkast til valideringsdatasett, to variablar per forløp
set.seed(1)
d_vld_utval_utkast = d_vld |>
  group_by(pasid, dato_inn) |>
  slice_sample(n = 2)

# Legg til info om hovud-biverknadsvariabel og filtrer på denne
d_reg_biverk = select(d_reg, pasid, dato_inn, biverk)
varnamn_undervar = c("biverk_hovud", "biverk_mage", "biverk_fot")
d_vld_utval_endeleg = d_vld_utval_utkast |>
  left_join(d_reg_biverk,
    by = c("pasid", "dato_inn"),
    relationship = "many-to-one"
  ) |>
  group_by(pasid, dato_inn) |>
  filter(impl(vld_varnamn %in% !!varnamn_undervar, biverk))

# Talet på observasjonar i datasetta
nrow(d_vld_utval_utkast)
#> [1] 10
nrow(d_vld_utval_endeleg)
#> [1] 9
Logikk basert på faste variabelsett
Nokre gongar heng eit sett variablar så sterkt saman at me vil sjå på / validera alle dersom me ser på minst éin av dei. Viss me for eksempel for eit forløp skal validera variabelen for magebiverknadar, vil me òg validera dei andre biverknadsvariablane, altså dei for hovud- og fotbiverknadar samt den generelle biverknadsvariabelen.
Det er fleire måtar å få dette til på. Her er eit eksempel der me, i
staden for å bruka slice_sample() til å filtrera vekk rader
direkte, først lagar ein «inklusjonsvariabel» som seier om den
aktuelle rada skal takast med (inkluderast) i valideringsdatasettet.
Dette mogleggjer meir avansert vidarebehandling, der verdien til
inklusjonsvariabelen kan avhenga av fleire rader:
# Viss minst éin av desse variablane inngår i valideringsdatasettet
# for eit forløp, så skal alle gjera det
varnamn_biverk = c("biverk", "biverk_hovud", "biverk_mage", "biverk_fot")

# Skal bruka indeksvariablane fleire gongar, så lagrar dei
# for enkelheits skuld som ein eigen variabel
indeksvar = quos(pasid, dato_inn)

set.seed(57)
d_vld_utval_utkast = d_vld_enkel |>
  group_by(!!!indeksvar) |>
  mutate(inkluder = row_number() %in% sample(row_number(), 2)) # To verdiar per forløp
filter(d_vld_utval_utkast, inkluder)
#> # A tibble: 10 × 5
#> # Groups:   pasid, dato_inn [5]
#>    pasid dato_inn   vld_varnamn vld_vartype inkluder
#>    <dbl> <date>     <chr>       <chr>       <lgl>
#>  1     5 2020-06-07 dato_ut     Date        TRUE
#>  2     5 2020-06-07 vekt        numeric     TRUE
#>  3     5 2020-12-13 hogd        numeric     TRUE
#>  4     5 2020-12-13 biverk      logical     TRUE
#>  5     7 2020-08-09 biverk      logical     TRUE
#>  6     7 2020-08-09 biverk_mage logical     TRUE
#>  7    13 2021-01-05 hogd        numeric     TRUE
#>  8    13 2021-01-05 gravid      logical     TRUE
#>  9    14 2021-01-05 dato_ut     Date        TRUE
#> 10    14 2021-01-05 gravid      logical     TRUE

# Generell hjelpefunksjon for å oppdatera inklusjonsstatus,
# der denne vert sett til TRUE for alle variablane med namn
# i «varnamn_gruppe» dersom minst éin av dei har
# inklusjonsstatus TRUE. Er meint å køyrast på grupperte datasett.
oppdater_inklusjonsstatus = function(inkluder, vld_varnamn, varnamn_gruppe) {
  er_variabel_i_gruppa = vld_varnamn %in% varnamn_gruppe
  if (any(inkluder[er_variabel_i_gruppa])) {
    inkluder[er_variabel_i_gruppa] = TRUE
  }
  inkluder
}

# Ta med alle biverknadsrader dersom minst éi er teken med (per forløp)
d_vld_utval_utkast = d_vld_utval_utkast |>
  group_by(!!!indeksvar) |>
  mutate(inkluder = oppdater_inklusjonsstatus(inkluder, vld_varnamn, !!varnamn_biverk))

# Fjern alle ikkje-inkluderte rader
d_vld_utval_endeleg = d_vld_utval_utkast |>
  filter(inkluder) |>
  select(-inkluder)
print(d_vld_utval_endeleg, n = Inf)
#> # A tibble: 15 × 4
#> # Groups:   pasid, dato_inn [5]
#>    pasid dato_inn   vld_varnamn  vld_vartype
#>    <dbl> <date>     <chr>        <chr>
#>  1     5 2020-06-07 dato_ut      Date
#>  2     5 2020-06-07 vekt         numeric
#>  3     5 2020-12-13 hogd         numeric
#>  4     5 2020-12-13 biverk       logical
#>  5     5 2020-12-13 biverk_hovud logical
#>  6     5 2020-12-13 biverk_mage  logical
#>  7     5 2020-12-13 biverk_fot   logical
#>  8     7 2020-08-09 biverk       logical
#>  9     7 2020-08-09 biverk_hovud logical
#> 10     7 2020-08-09 biverk_mage  logical
#> 11     7 2020-08-09 biverk_fot   logical
#> 12    13 2021-01-05 hogd         numeric
#> 13    13 2021-01-05 gravid       logical
#> 14    14 2021-01-05 dato_ut      Date
#> 15    14 2021-01-05 gravid       logical
Lagring og lesing av valideringsdatasett
Eigna filformat og dataprogram for utfylling
Formatet på valideringsdatasetta er utforma slik at datasetta lett kan brukast i ulike dataprogram/filformat. Ein står fritt til sjølv å velja kva filformat ein vil bruka når ein skal fylla ut valideringsdatasetta med verdiane frå den eksterne kjelda.
Me tilrår likevel sterkt å bruka anten eit databaseverktøy eller eit statistikkprogram som sikrar dataintegriteten. Programmet bør sikra at ein for eksempel ikkje ved ein feil skriv inn tekst eller tal i ein kolonne som berre tek datoar.
Både SPSS og Stata er statistikkprogram som er godt eigna. Me frårår på det sterkaste å bruka Microsoft Excel. Me viser her eit par eksempel på korleis ein kan lagra valideringsdatasettet vårt til SPSS-format.
Fullstendig valideringsdatasett til SPSS-format
For å lagra valideringsdatasettet som SPSS-format kan me bruka
write_sav() frå haven-pakken:
# Definerer mappe og filnamn for lagring
mappe_vld = "h:\\valideringsdata\\"
filnamn = "valideringsdatasett.sav"
filadresse = paste0(mappe_vld, filnamn)

# Opprett mappa (om ho ikkje finst frå før)
dir.create(mappe_vld, showWarnings = FALSE, recursive = TRUE)

# Lagra valideringsdatasett på SPSS-format
haven::write_sav(d_vld, filadresse)
For lesing av ferdigredigerte valideringsfiler brukar me tilsvarande
read_spss().
Eitt valideringsdatasett per sjukehus til SPSS-format
Når me reiser rundt og validerer, gjer me det jo for eitt og eitt sjukehus, så ofte vil det vera føremålstenleg å ha éi fil per sjukehus. Me har gjerne sjukehusinfo for kvart forløp lagra i eit separat datasett:
d_forlopsinfo
#> # A tibble: 5 × 3
#>   pasid dato_inn   sjukehus
#>   <dbl> <date>     <chr>
#> 1     5 2020-06-07 Bergen
#> 2     5 2020-12-13 Førde
#> 3     7 2020-08-09 Bergen
#> 4    13 2021-01-05 Førde
#> 5    14 2021-01-05 Førde
Me må først kopla sjukehusnamna på valideringsdatasettet. Me
genererer så filnamn basert på desse namna. For å få meir maskinvennlege
filnamn brukar me i dette eksempelet
to_any_case()-funksjonen i snakecase-pakken.
(Slik me brukar han, vil han for eksempel gjera om
"Helse Førde" til "helse_forde".) Til slutt er
det berre å dela opp valideringsdatasettet i eitt datasett per sjukehus
og lagra desse datasetta i separate filer:
# Hekt på sjukehusnamn
d_vld_med_sjukehus = d_vld |>
  left_join(d_forlopsinfo,
    by = c("pasid", "dato_inn"),
    relationship = "many-to-one"
  )

# Generer maskinvennlege filadresser
library(snakecase)
d_vld_med_sjukehus = d_vld_med_sjukehus |>
  mutate(
    filnamn = paste0(to_any_case(sjukehus, transliterations = "Latin-ASCII"), ".sav"),
    filadresse = paste0(mappe_vld, filnamn)
  )

# Del opp datasettet i eitt per sjukehus/filamn,
# og lagra dei som separate filer
d_vld_med_sjukehus |>
  split(.$filadresse) |>
  iwalk(write_sav)
Me kan bruka tilsvarande metodikk viss me vil ha éi fil per årstal, per månad eller per sjukehus per månad. Når me så har fylt ut valideringsdatasetta i SPSS, kan me enkelt lasta dei alle inn til eitt stort datasett slik:
filadresser = list.files(mappe_vld, pattern = "\\.sav$", full.names = TRUE)
d_vld_utfylt = filadresser |>
  map(read_sav) |>
  purrr::list_rbind()
Statistiske aspekt ved bruk av valideringsdata
Korleis me vel ut tilfeldige målingar (samplingsmetoden), påverkar kva storleikar me kan estimera og korleis me kan estimera dei.
Me kan, som tidlegare vist, bruka enkelt tilfeldig utval og ulike former stratifiserte utval. Me skal no sjå nærare på dei statistiske eigenskapane desse har, og til slutt skal me komma med nokre generelle råd om samplings- og analysemetodar.
Enkelt tilfeldig utval
La oss først tenkja oss at me plukkar ut heilt tilfeldige
målingar frå heile registeret (med slice_sample(),
anten eit visst tal målingar eller ein viss prosentdel). Då kan me
estimera blant anna desse storleikane direkte:
- Prosentdelen målingar som er rette i heile registeret (total korrektheit).
- Prosentdelen av éin type måling (eks. biverknadar) som er rett i heile registeret.
- Prosentdelen målingar som er rette per sjukehus.
- Prosentdelen av éin type måling som er rett per sjukehus.
Estimata (laga med aggreger_ki_prop(), eventuelt med
group_by() først) vert forventingsrette og
konfindensintervalla gyldige.
Denne samplingsmetoden er den enklaste og mest fleksible, då han lett kan gje svar på alle moglege problemstillingar. Men han har òg nokre ulemper.
La oss tenkja oss at me har eit register med tre sjukehus av svært ulik storleik, og dermed ulikt pasienttal i registeret:
| Eining | Pasientar |
|---|---|
| Sjukehus A | 70 |
| Sjukehus B | 400 |
| Sjukehus C | 6700 |
Kvar pasient er registrert med 10 variablar. Me plukkar 100 tilfeldige målingar. Då vert forventa tal på trekte målingar per sjukehus om lag:
| Eining | Pasientar | Målingar | Trekte |
|---|---|---|---|
| Sjukehus A | 70 | 700 | 1 |
| Sjukehus B | 400 | 4000 | 6 |
| Sjukehus C | 6700 | 67000 | 93 |
Her kan me i teorien svara på alle spørsmåla ovanfor, men det er klart at me likevel har altfor få målingar frå sjukehus A til å seia noko om korrektheita for dette sjukehuset.
Stratifisert tilfeldig utval
Viss me er interesserte i tala per sjukehus, kan me heller bruka ein samplingsmetode der me plukkar ut like mange målingar per sjukehus:
| Eining | Pasientar | Målingar | Trekte |
|---|---|---|---|
| Sjukehus A | 70 | 700 | 33 |
| Sjukehus B | 400 | 4000 | 33 |
| Sjukehus C | 6700 | 67000 | 33 |
Me kan så estimera kor stor del av målingane som er korrekte per sjukehus, og med om lag same presisjon for alle sjukehusa. Estimata kan me bruka for å samanlikna sjukehusa (gjerne med SPC-metodikk). Då får me for eksempel:
| Eining | Pasientar | Målingar | Trekte | Korrekte | Del korrekte |
|---|---|---|---|---|---|
| Sjukehus A | 70 | 700 | 33 | 13 | 0.39 |
| Sjukehus B | 400 | 4000 | 33 | 25 | 0.76 |
| Sjukehus C | 6700 | 67000 | 33 | 31 | 0.94 |
Det ser ut til at det minste sjukehuset, sjukehus A, har lågast korrektheit.
Me kan òg bruka dei same dataa for direkte å svara på korrektheit per variabel per sjukehus (men bør sjølvsagt ha fleire trekte målingar for å få presise estimat).
Men viss me vil ha svar på kor stor del av målingane i heile
registeret som er rette, kan me ikkje lenger bruka
aggreger_ki_prop() direkte. Det vil gje både feil estimat
og feil konfidensintervall. Her vil det gje estimatat (13 + 25 + 31) /
(33 + 33 + 33) = 69 / 99 = 0.70. Men dette svaret er openbert feil. Dei
dårlege resultata frå vesle sjukehus A har fått altfor stor vekt.
Metoden ovanfor vil nemleg berre vera gyldig dersom det ikkje finst forskjellar i korrektheit mellom sjukehusa eller dersom alle sjukehusa er like store (har like mange målingar i registeret).
Rett analysemetode er å rekna ut eit vekta snitt av dei tre estimata, vekta etter talet på målingar som er gjorde per sjukehus:
| Eining | Målingar | Trekte | Korrekte | Del korrekte | Del målingar |
|---|---|---|---|---|---|
| Sjukehus A | 700 | 33 | 13 | 0.39 | 0.010 |
| Sjukehus B | 4000 | 33 | 25 | 0.76 | 0.056 |
| Sjukehus C | 67000 | 33 | 31 | 0.94 | 0.934 |
Rett (og forventingsrett) estimat på kor stor del av målingane i heile registeret som er korrekte, vert då cirka 0.92. Dette estimatet er nært estimatetet til sjukehus C, sidan dette sjukehuset har dei fleste pasientane/målingane i registeret.
Utrekning av tilhøyrande konfidensintervall vert meir komplisert.
Viss estimata ikkje er veldig små og ikkje er baserte på veldig få
observasjonar, kan me rekna ut standardfeil for kvart av dei tre
estimata, rekna ut standardfeilen for ein vekta sum av uavhengige
variablar, og så bruka normaltilnærminga. Men i praksis er det betre å
bruka funksjonar i ein ferdig R-pakke, for eksempel survey-pakken.
Råd ved komplisert sampling
Ved meir kompliserte samplingsmetodar må ein halda tunga rett i
munnen dersom ein vil rekna ut (forventings)rette estimat på
korrektheit – og tilhøyrande konfidensintervall. Me tilrår å bruka
survey-pakken og ta kontakt med ein statistikar.
Ein statistikar bør òg vera involvert når ein vel samplingsmetode i utgangspunktet, for å sikra at ein seinare kan få (både rette og presise) svar/estimat på dei spørsmåla ein ønskjer.
Viss det ikkje er veldig stor forskjell i storleiken på sjukehusa, eller viss ein ikkje treng stratifiserte estimat, tilrår me å bruka enkelt tilfeldig utval (dvs. eit tilfeldig utval der alle relevante målingar i registeret har likt sannsyn for å verta trekte). Då gjer ein livet enklare for seg sjølv!
Til slutt har me nokre relevante litteraturkjelder som de kan vurdera å lesa:
-
Complex
Surveys: A Guide to Analysis Using R (bok om
survey-pakken) - En praktisk innføring i utvalgsplanlegging (notat frå SSB)